Zakaj običajno odpravljanje hrupa ni dovolj?
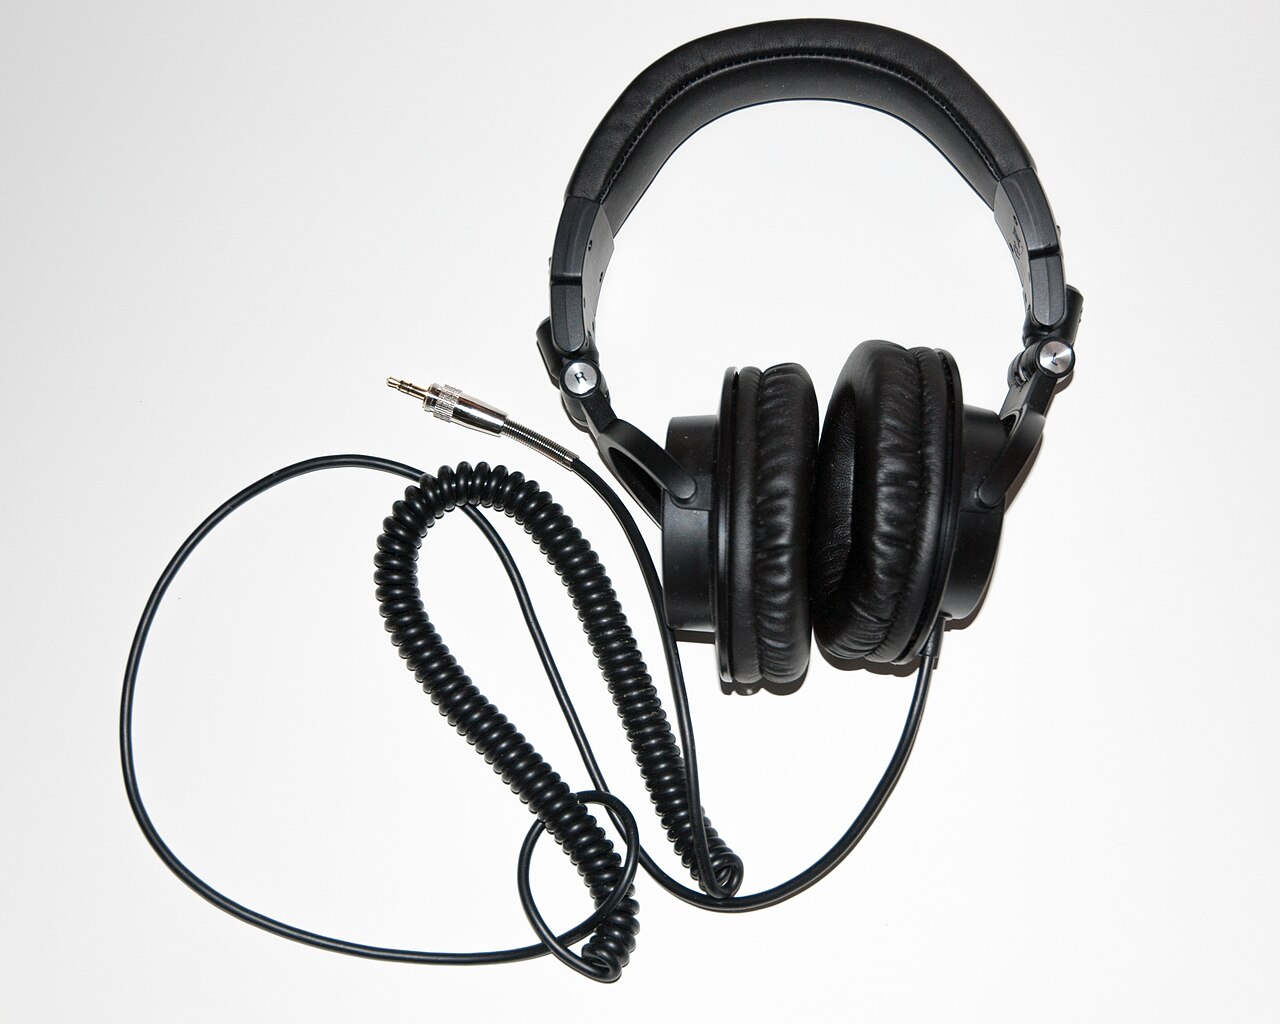
Slušalke z aktivnim odpravljanjem hrupa z mikrofoni ocenijo zvok iz okolice in ustvarijo signal, ki ga ob ušesu delno zmanjša. To je koristno predvsem pri enakomernem hrupu motorja ali prezračevanja. Če govori več ljudi hkrati, je problem drugačen. Če utišamo vse, utišamo tudi človeka, ki ga želimo slišati. Ohraniti moramo en gibajoč se glas, druge s podobnimi frekvencami pa oslabiti.
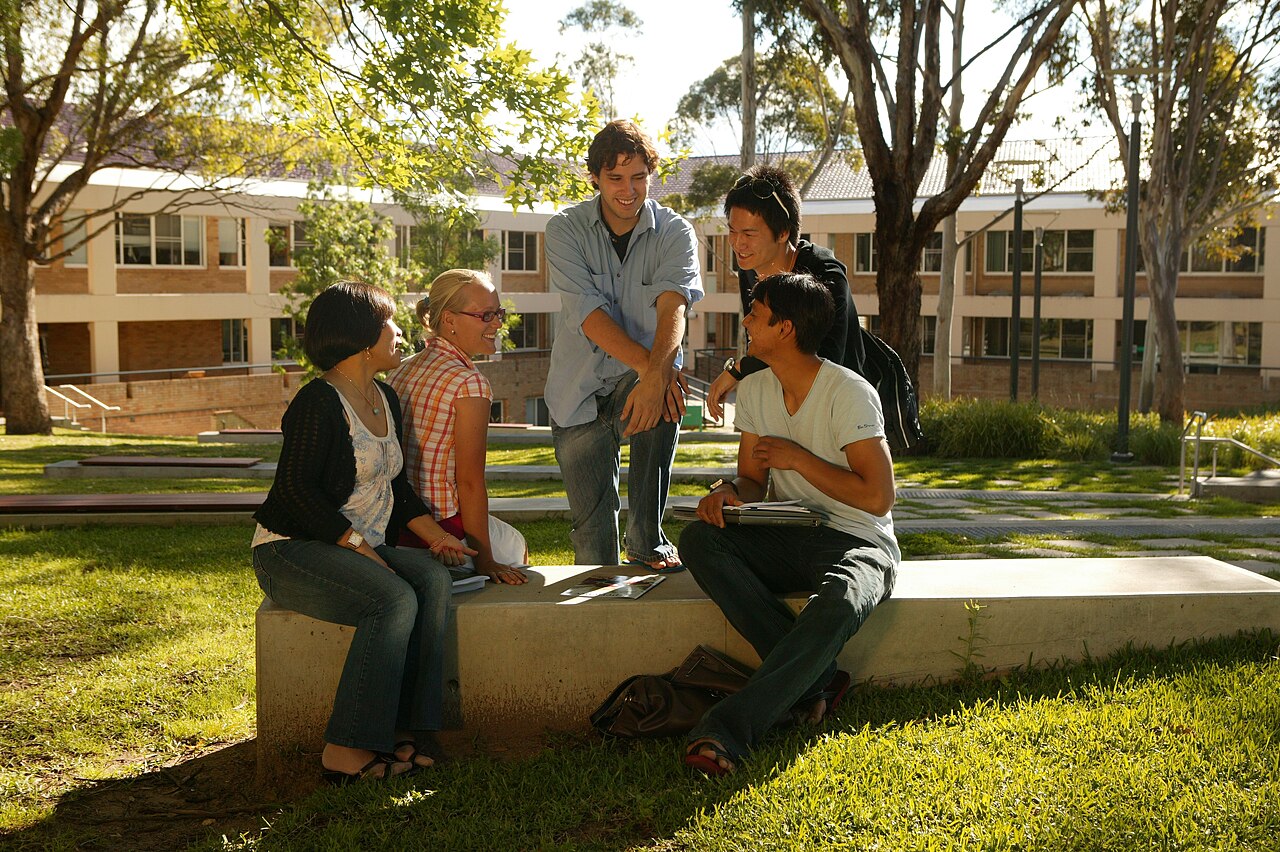
Predstavljajmo , da mikrofoni zajamejo tri govorce. Posnetek ne vsebuje treh lepo označenih zvočnih sledi, ki bi jih lahko preprosto izključili. Govor se prekriva v času in po frekvencah, odmev prostora pa ga dodatno meša. Pri obdelavi signalov je to . Smer izvora pomaga, vendar ne zadostuje: oseba se lahko premakne za nas, nekdo drug pa zavzame njeno prejšnje mesto. Uporabna naprava mora zapomniti, kateri glas spremlja, ne le prvotne smeri.
UNE Photos / Wikimedia Commons · Viri ↗ · Pogoji uporabe slike ↗
Kako uporabnik izbere sogovornika?
Sistem se imenuje Target Speech Hearing, poslušanje izbranega govorca. Uporabnik obrne glavo k osebi in pritisne gumb. Mikrofoni na obeh straneh slušalk nekaj sekund snemajo njen glas skupaj z okolico. Če je govorec približno pred uporabnikom, njegov zvok do obeh mikrofonov prispe skoraj hkrati. Ta pomaga iz mešanice pridobiti kratek vzorec glasu. Univerzitetni opis navaja približno 16 stopinj dovoljene razlike v smeri.
Naslov raziskave pravi »poglej enkrat«, vendar naprava ne spremlja oči in ne bere misli. Pomembna sta obrat glave in pritisk gumba. Prav tako ne potrebuje vnaprej pripravljenega čistega posnetka. Iz nekaj sekund hrupnega zvoka poskuša izluščiti lastnosti izbranega glasu in ga nato iskati v naslednjih delih posnetka, tudi če se poslušalec ali govorec premakneta.
Računanje poteka v majhnem računalniku, povezanem s slušalkami. Model sprejme kratke nove odseke zvoka, oceni, kateri del pripada izbranemu govorcu, in obdela signal za slušalke. Znanstveni članek opisuje bloke po osem milisekund in skupno reda nekaj deset milisekund. To je pomembno: če bi glas prihajal z veliko zamudo, bi pogovor zvenel nenaravno in mu ne bi mogli slediti.
Kaj je poskus dejansko pokazal?
Skupina je sistem preizkusila v različnih notranjih in zunanjih prostorih, med gibanjem ljudi in ob več virih zvoka. V študiji z 21 udeleženci so poslušalci jasnost izbranega glasu v povprečju ocenili skoraj dvakrat bolje kot pri neobdelanem posnetku. Članek poroča tudi o izboljšanju enega objektivnega kazalnika kakovosti signala za približno sedem decibelov. Rezultati so obetavni za , ne dokazujejo pa, da bo vsak pogovor povsod zvenel brezhibno.
»Skoraj dvakrat bolje« se nanaša na oceno udeležencev konkretnega preizkusa, ne na splošno podvojitev števila razumljenih besed. Potrebne so širše študije z več poslušalci, jeziki, glasovi, vrstami hrupa in napravami. Posebej pomembno bi bilo preveriti delovanje pri ljudeh z različnimi oblikami izgube sluha. Raziskovalni iz leta 2024 takrat ni bil izdelek, ki bi ga lahko kupili.
Pri presoji takšne tehnologije je treba razlikovati med kakovostjo zvočnega signala in dejanskim razumevanjem pogovora. Čistejši posnetek lahko še vedno vsebuje nerazumljive besede, če se govorec obrne stran ali če je govor zelo tih. Ocene ljudi dopolnjujejo računalniške meritve, vendar niti ena vrsta meritve sama ne zajame vsakega resničnega pogovora.
Dvortygirl & Mysid / Wikimedia Commons · Viri ↗ · Pogoji uporabe slike ↗
Kje so trenutne omejitve?
Po navedbah avtorjev zdajšnji sistem izbere samo enega govorca naenkrat. Če v trenutku izbire iz skoraj iste smeri govori še druga glasna oseba, lahko shrani napačen glas. Uporabnik lahko nato postopek ponovi. Utišanje drugih zvokov odpira tudi varnostno vprašanje: na ulici in v prometu je treba slišati opozorila. Študija ni merila prometne varnosti; to je praktična skrb pri vsakem pripomočku, ki spreminja naš sluh.
Pomembna je tudi zasebnost. Da sistem deluje, morajo mikrofoni sprejemati zvok iz okolice, zato mora prihodnji izdelek pojasniti, kako ga obdeluje in shranjuje. V opisanem izračuni potekajo v računalniku ob slušalkah. To kaže, da vsakega pogovora ni treba pošiljati na oddaljen strežnik. Iz pa ne smemo sklepati o pravilih zasebnosti morebitnega prihodnjega komercialnega izdelka.
Zakaj bi to lahko koristilo?
Jasnejši glas izbranega sogovornika lahko pomaga pri pouku, v restavraciji ali javnem prostoru. Razumevanje govora v hrupu je dolgotrajen izziv za ljudi, ki uporabljajo slušne aparate. Ameriški Nacionalni inštitut za gluhost in druge komunikacijske motnje to izpostavlja kot pomemben problem slušne tehnologije. Avtorji želijo metodo nekoč prilagoditi manjšim slušalkam in slušnim aparatom. Za zdaj pa ni podlage, da bi njihov imenovali medicinsko preverjen slušni pripomoček.
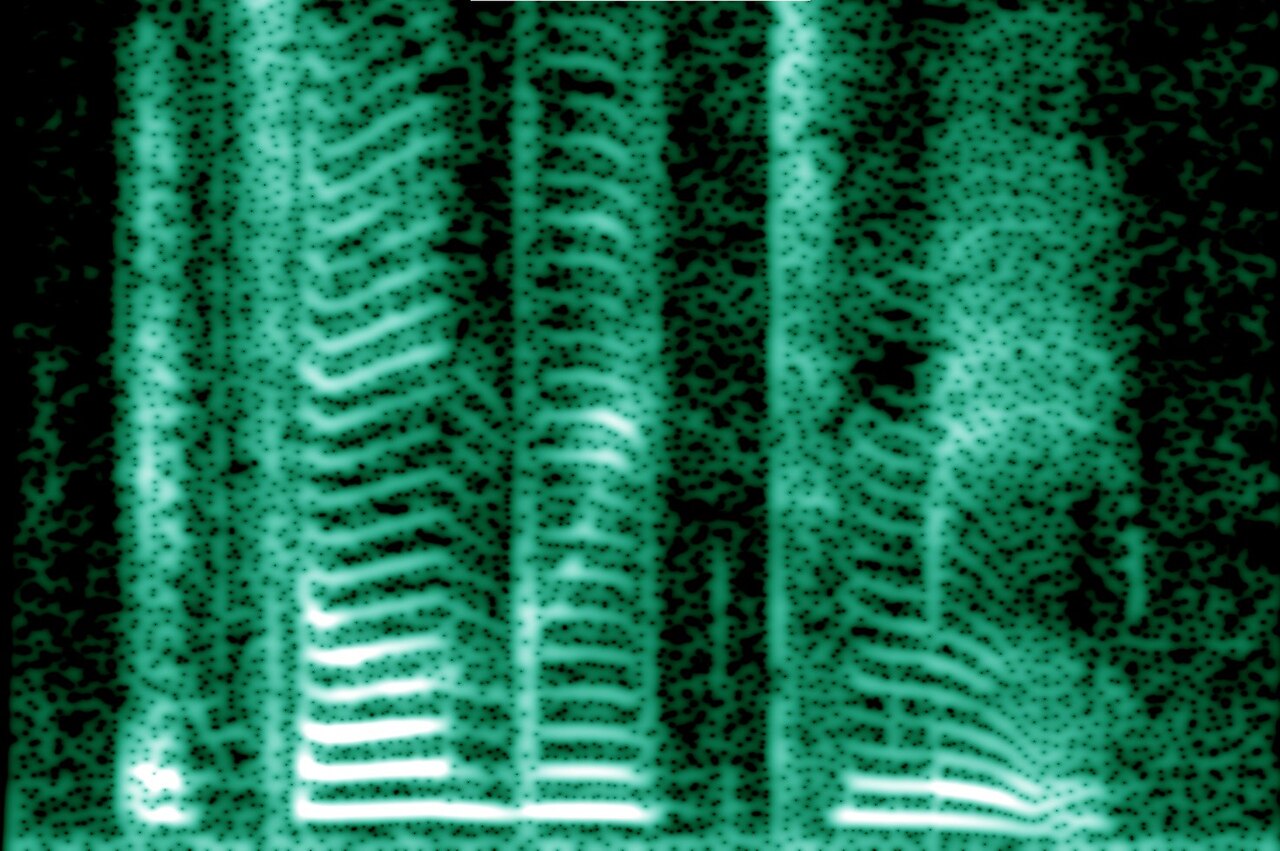
Zanimiva je povezava akustike in strojnega učenja. Položaj mikrofonov in čas prihoda zvoka pomagata pridobiti začetni vzorec; model prepozna značilnosti glasu in mu sledi, ko se prizor spreminja. Ne gre za čarobno umetno inteligenco, ki razume vsak stavek. Sistem zelo hitro ocenjuje, kateri deli zapletenega zvočnega vala najverjetneje pripadajo izbrani osebi. Njegovo resnično vrednost bo pokazalo, koliko ljudem olajša pogovor, ob jasnem upoštevanju tega, kar je bilo doslej preizkušeno.
V prihodnji različici bi bilo koristno preveriti tudi, kako preprosto lahko uporabnik zamenja sogovornika ali znova vključi zvoke okolice. Takšne odločitve so del zasnove izdelka, ne le zmogljivosti algoritma. Sistem je uporaben šele takrat, ko se lahko človek v pogovoru nanj zanese brez zapletenih nastavitev.
Pojmi
— izločanje enega signala iz mešanice; — podatek o smeri izvora zvoka; — čas med vhodnim in obdelanim zvokom; — raziskovalna različica, ki še ni končni izdelek.