Zašto obična zaštita od buke nije dovoljna?
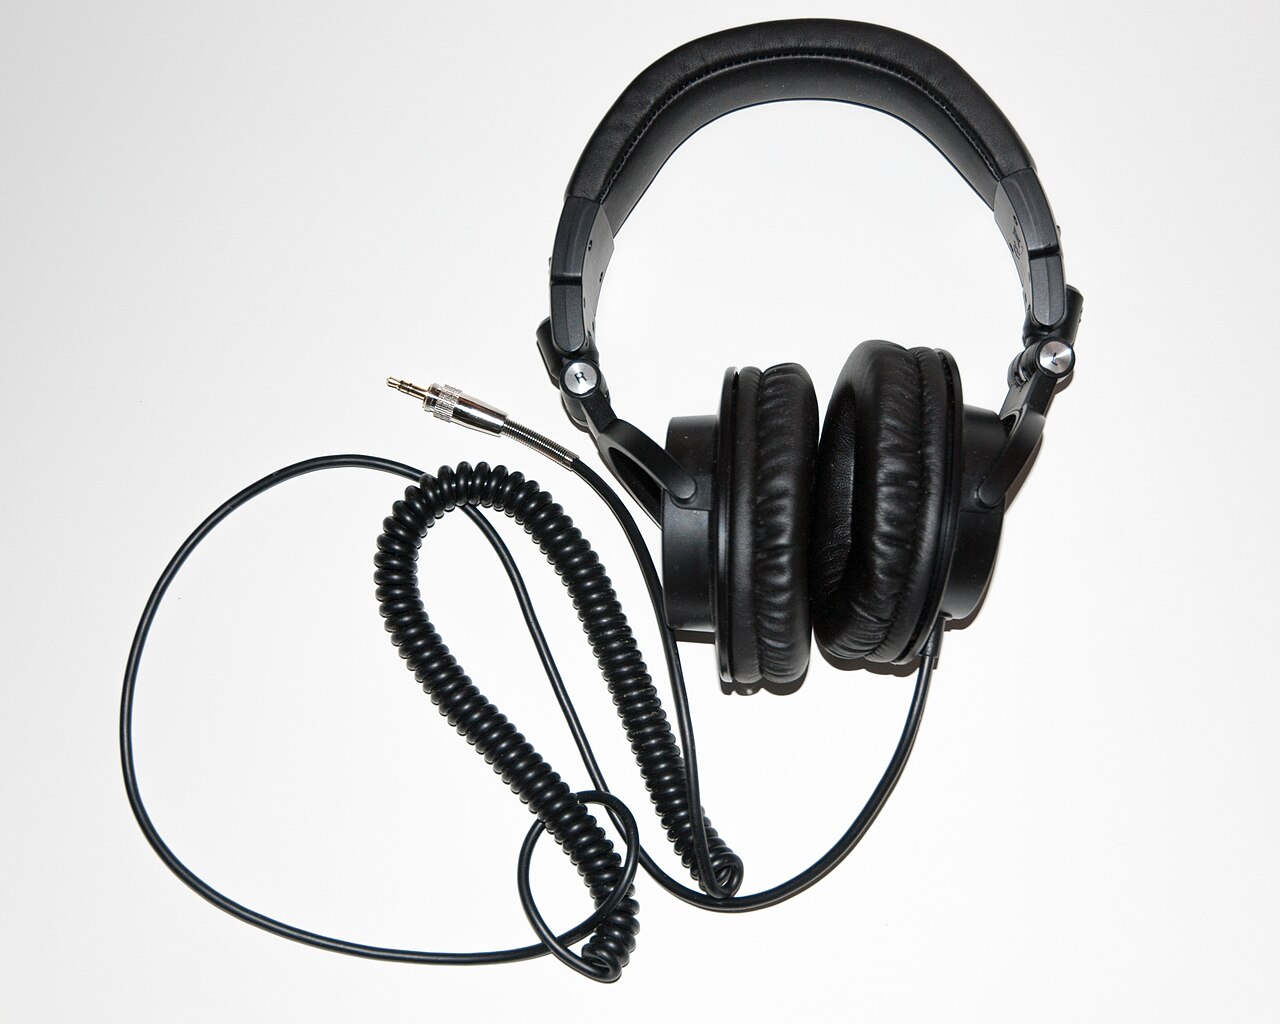
Slušalice sa aktivnim poništavanjem buke koriste mikrofone da procene spoljašnji zvuk i zatim proizvedu signal koji smanjuje deo tog zvuka u uhu. Taj pristup je koristan, naročito za postojanu buku poput motora ili ventilacije. Problem je drugačiji kada istovremeno govori više ljudi. Nije dovoljno „utišati sve“: potrebno je zadržati jednog sagovornika, a potisnuti druge čiji glasovi imaju slične frekvencije i stalno se menjaju.
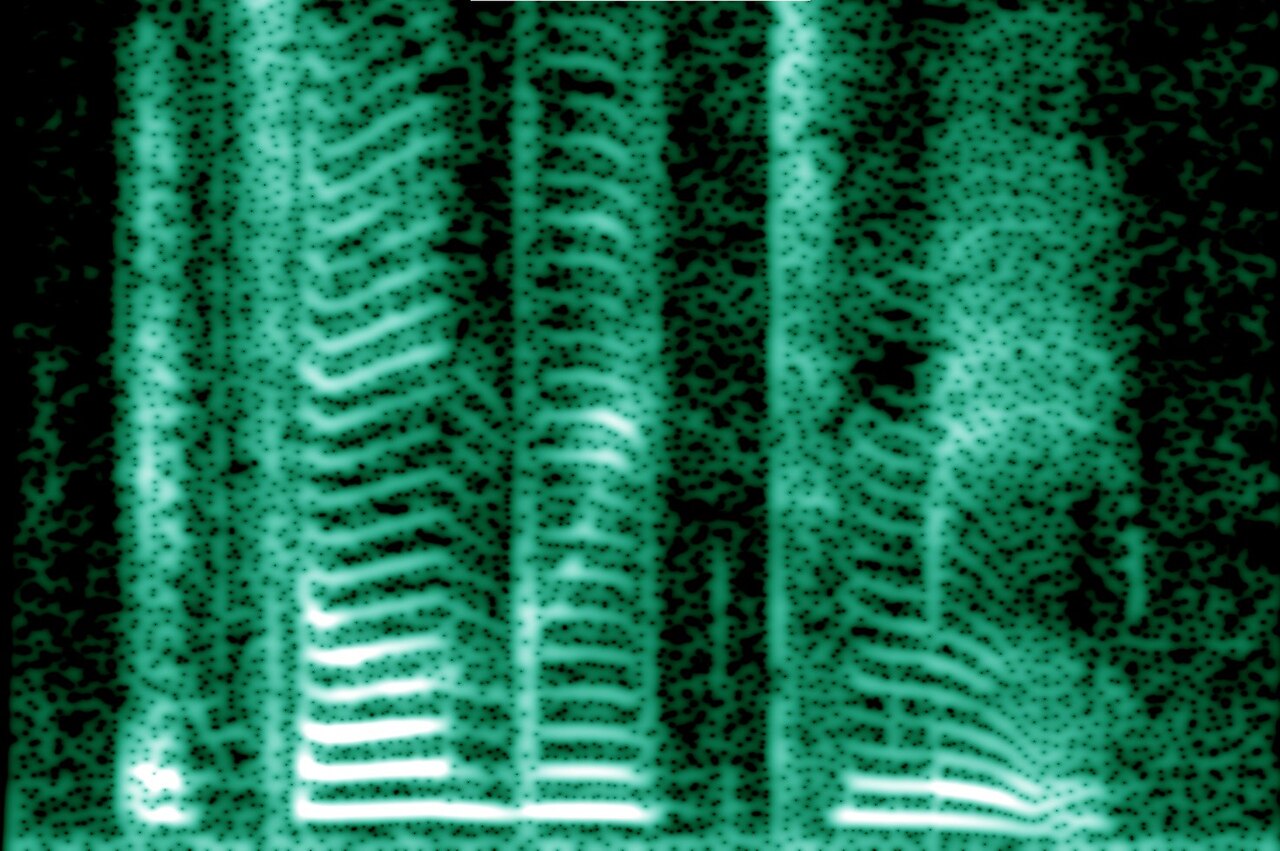
Zamisli da su mikrofoni snimili zbir tri glasa. U snimku nema tri uredno označene audio-trake koje se mogu jednostavno isključiti. Glasovi se preklapaju u vremenu i spektru, a odjek prostorije ih dodatno meša. U obradi signala to je problem razdvajanja izvora zvuka. Smer iz kog glas dolazi pomaže, ali nije dovoljan: osoba može krenuti iza tebe, a neko drugi zauzeti njeno mesto. Zato je istraživačima bio potreban način da sistem „zapamti“ koji glas prati, ne samo odakle on dolazi.
UNE Photos / Wikimedia Commons · Izvori ↗ · Uslovi korišćenja slike ↗
Kako se bira sagovornik?
Sistem se zove Target Speech Hearing, odnosno slušanje izabranog govornika. Korisnik okrene glavu ka osobi koja govori i pritisne dugme. Tokom nekoliko sekundi mikrofoni sa leve i desne strane slušalica snime glas i okolnu buku. Kada je govornik približno ispred korisnika, zvučni talasi njegovog glasa stižu do oba mikrofona gotovo istovremeno. Taj pomaže sistemu da iz mešavine izdvoji kratak uzorak. Prema univerzitetskom opisu, dozvoljeno odstupanje smera bilo je oko 16 stepeni.
Naslov istraživanja kaže „pogledaj jednom“, ali uređaj ne prati oči i ne čita nečije misli. Važno je okretanje glave i pritisak na dugme. Nije mu potreban savršeno čist snimak sagovornika od ranije: pokušava da izvuče obeležja njegovog glasa iz nekoliko sekundi bučnog snimka. Model zatim taj glas traži u narednim delovima zvuka, čak i kada se korisnik ili sagovornik pomere.
Računanje se obavlja na malom računaru povezanom sa slušalicama. Model dobija nove kratke delove zvuka, procenjuje koji deo odgovara izabranom govorniku i vraća obrađen signal u slušalice. U naučnom radu istraživači navode obradu blokova od osam milisekundi i ukupno reda desetina milisekundi. To je važno: ako bi glas stizao sa velikim zakašnjenjem, razgovor bi postao neprirodan i teško upotrebljiv.
Šta je zapravo pokazao eksperiment?
Tim je sistem ispitivao u različitim unutrašnjim i spoljašnjim okruženjima, sa ljudima koji se kreću i sa više izvora zvuka. U studiji sa 21 učesnikom ljudi su, u proseku, ocenili jasnoću izabranog glasa skoro dvostruko bolje nego kod neobrađenog snimka. Naučni rad takođe prijavljuje poboljšanje jednog objektivnog pokazatelja kvaliteta signala za oko sedam decibela. To su obećavajući rezultati za ; nisu dokaz da će svaki razgovor u svakom prostoru zvučati savršeno.
„Skoro dvostruko bolje“ odnosi se na ocenu učesnika u konkretnom eksperimentu, a ne na univerzalno udvostručenje razumevanja svakog izgovorenog sloga. Za širu procenu potrebna su ispitivanja na većem broju ljudi, sa različitim jezicima, glasovima, vrstama buke i uređajima. Posebno bi trebalo proveriti kako sistem radi kod ljudi sa različitim stepenima oštećenja sluha. Istraživački iz 2024. nije potrošački proizvod koji se tada mogao kupiti.
Dvortygirl & Mysid / Wikimedia Commons · Izvori ↗ · Uslovi korišćenja slike ↗
Gde su granice sadašnjeg sistema?
Prema samim autorima, sadašnji sistem bira samo jednog govornika u datom trenutku. Ako u času izbora drugi glasan čovek govori iz gotovo istog smera, uređaj može pogrešiti pri „upisu“ ciljnog glasa. Korisnik tada može ponoviti postupak. Prigušivanje drugih zvukova takođe otvara praktično pitanje bezbednosti: u saobraćaju ili na ulici korisnik mora moći da čuje upozorenja i okolinu. To nije rezultat studije o bezbednosti, nego razumna projektantska briga za svaku tehnologiju koja menja ono što čujemo.
Tu je i pitanje privatnosti. Mikrofoni moraju stalno primati zvuk da bi sistem radio, pa je važno kako bi budući uređaji obrađivali i čuvali te podatke. U prikazanom obrada se odvija na računaru uz slušalice, što pokazuje da je moguće raditi bez slanja svakog razgovora na udaljeni server. Ipak, pravila privatnosti budućeg komercijalnog proizvoda zavisila bi od njegove konkretne izrade. Ne treba ih pripisivati unapred.
Zašto bi ovo moglo biti korisno?
Jasnije izdvajanje izabranog govornika može pomoći u nastavi, razgovoru u restoranu ili javnom prostoru. Za ljude koji koriste slušne aparate, razumevanje govora u buci je dugotrajan izazov. Američki Nacionalni institut za gluvoću i druge komunikacijske poremećaje naglašava da je to jedan od problema savremene tehnologije pomagala za sluh. Autori žele da svoj pristup u budućnosti prilagode i manjim slušalicama i slušnim aparatima. Za sada, međutim, nema osnova da se kaže da je njihovo rešenje medicinski provereno pomagalo.
Možda je najzanimljiviji način na koji se ovde spajaju akustika i mašinsko učenje. Položaj mikrofona i vreme dolaska zvuka pomažu da se dobije početni uzorak, a model prepoznaje osobine glasa i prati ga dok se scena menja. Nije reč o „čarobnoj“ veštačkoj inteligenciji koja razume svaku reč: reč je o sistemu koji za veoma kratko vreme donosi mnogo procena o tome koji delovi složenog zvučnog talasa najverovatnije pripadaju izabranoj osobi. Njegova vrednost se meri time koliko stvarni ljudi lakše razgovaraju, uz jasne granice onoga što je zaista testirano.
Pojmovi
— izdvajanje jednog signala iz mešavine; — podatak o smeru izvora zvuka; — vreme između ulaznog i obrađenog zvuka; — istraživačka verzija uređaja koja još nije gotov proizvod.